RT-DETR: Penjelasan konsep cara kerja model. (id)
 itsnnka
30 September 2026
Pembuka
Apa jadinya kalau kita bisa mendeteksi objek secara real-time? RT-DETR(Real-Time Detection Transformer) menjawab pertanyaan itu. Berbeda dari pendahulunya Deformable DETR, RT-DETR menawarkan pendekatan end-to-end tanpa post-processing yang bikin lambat. Tapi, bagaimana sebenarnya cara kerjanya? Apa yang membuatnya bisa cepat sekaligus akurat? Pada kajian ini, aku (peneliti) akan membedah RT-DETR langkah demi langkah beserta komponen utamanya.
Sejarah dan Kajian Teori
Data berurutan (sequential data) merupakan jenis data yang memiliki urutan atau posisi yang penting, di mana setiap elemen pada data saling berhubungan berdasarkan waktu atau posisi tertentu. Sebelum adanya model attention, model AI untuk data berurutan seperti teks maupun time-series umumnya menggunakan RNN (Recurrent Neural Network). Namun model ini memiliki kekurangan, dimana RNN melakukan komputasi atau penghitungan secara berurutan sehingga proses paralelisasi atau penyelarasan data terhambat selama pelatihan. Dalam hal ini, ketergantungan jarak jauh (Long-Range Dependencies) merujuk pada hubungan atau ketergantungan antar sinyal dari dua posisi yang berjauhan dalam suatu urutan input atau output. Selain menghambat paralelisasi data, model berbasis RNN juga memiliki tantangan dalam memelajari ketergantungan jarak jauh, karena jumlah operasi yang dibutuhkan untuk menghubungkan dua posisi dalam urutan meningkat seiring bertambahnya jarak antar posisi tersebut. Dalam hal tersebut, arsitektur model Transformer hadir untuk mengatasi permasalahan di atas dengan mengandalkan mekanisme self-attention a.k.a intra-attention—sebuah mekanisme yang memungkinkan untuk menghubungkan berbagai posisi dari satu urutan untuk menghitung representasi urutan tersebut, hal tersebut memudahkan paralelisasi dan efektif dalam menangkap ketergantungan jarak jauh tanpa memedulikan jaraknya dalam urutan (Vaswani et al, 2017:2 & 6).
Komponen utama dari arsitektur ini adalah Scaled Dot-Product Attention (SDPA)—yaitu, fungsi yang memetakan sebuah query (Q) dan sekumpulan pasangan Key (K) dan Value (V) menjadi sebuah output melalui perhitungan similarity score dari nilai-nilai tersebut (Vaswani et al, 2017:3). Query sendiri merepresentasikan vektor yang sedang diproses, misalnya kata dalam kalimat. Sedangkan Key merupakan vektor yang merepresentasikan vektor lain ke dalam urutan yang mungkin relevan dengan Query. Kemudian, Value merupakan vektor yang merepresentasikan nilai atau informasi dari vektor-vektor tersebut. Proses perhitungan yang telah dijelaskan sebelumnya dilakukan dengan menghitung jumlah dot product (perkalian titik untuk mengukur kemiripan) antara Query dengan seluruh Key, yang hasilnya dibagi dengan faktor skala berupa akar kuadrat dari dimensi key per-head atau dk . Oleh karena itu, penskalaan ini menjadi titik yang sangat penting karena membuat angka pada dot product yang membesar menjadi kecil atau dinormalisasikan.
Pada kajian ini, fokus pada SDPA oleh model RT-DETR digunakan untuk memahami dan mempelajari antar pola pada sebuah objek/detail dari suatu gambar. Proses attention dapat dilakukan secara bersamaan, hal ini membuat model tidak hanya fokusnya pada 1 pola melainkan banyak pola sekaligus. Untuk meningkatkan kemampuan model tersebut, digunakanlah Multi-Head Attention (MHA) yang memproyeksikan Query, Key, dan Value secara linear sebanyak nilai head (h) sehingga proses SDPA dapat dijalankan secara paralel pada representasi yang berbeda. Hasil dari seluruh head ini kemudian digabungkan dan diproyeksikan kembali menggunakan matriks proyeksi output untuk menghasilkan representasi akhir.
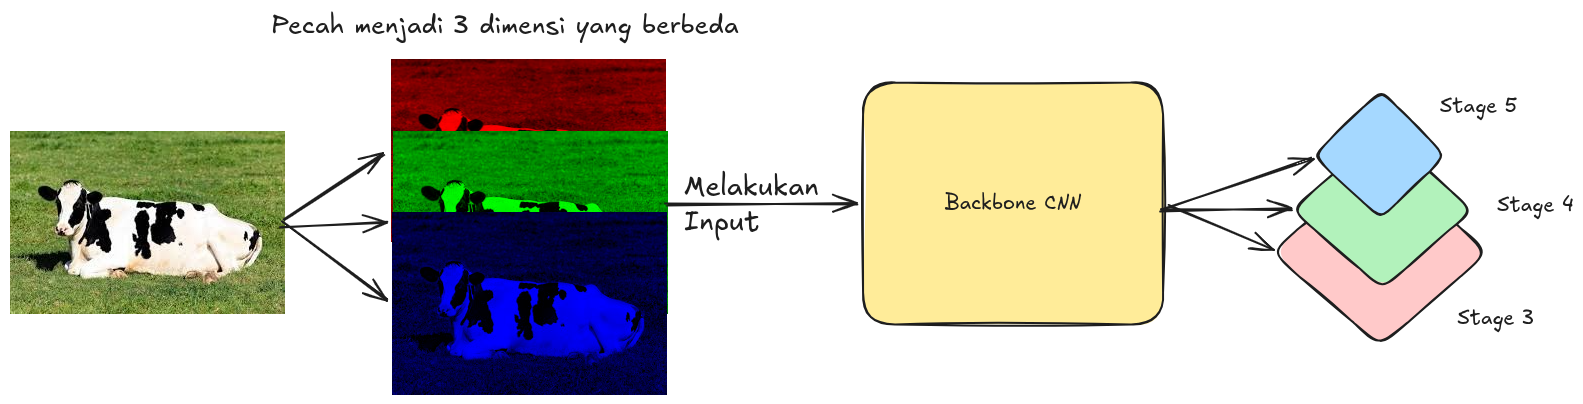
Gambar 1.1 Backbone model RT-DETR. Sumber: (Kompetisi Karya Ilmiah oleh Dokumentasi Peneliti, 2026).
Sebelum dianalisis oleh model AI, gambar (citra) yang diperoleh dari kamera akan direpresentasikan dengan mengubahnya menjadi sebuah input berbentuk susunan angka dengan sebuah notasi matematika sebagai $x_{img} \in \mathbf{R}^{3 \times H_0 \times W_0}$ di mana $x_{img}$ merupakan citra yang terdiri dari 3 dimensi blok angka yang memiliki warna yang berbeda yaitu Red, Green, Blue (RGB) dengan masing-masing dimensi merepresentasikan tinggi dan lebar (tinggi $\times$ lebar) pada suatu gambar yang dinyatakan dalam $H_0 \times W_0$ (Carion dkk., 2020:6).
Kemudian model AI akan memproses data tersebut dengan backbone yaitu komponen dari model RT-DETR—berfungsi untuk mengekstrak bagian-bagian feature oleh model ResNet (Residual Network) (lihat gambar 1.1). Dalam hal ini, feature adalah representasi data yang dihasilkan oleh suatu proses dan sekaligus digunakan sebagai input untuk proses berikutnya. Backbone pada feature ximg akan menghasilkan 3 feature yang dinyatakan sebagai stage (S) dengan berbagai skala yang berbeda-beda, yang mana setiap $S_i$ merupakan bilangan riil yang terdiri dari susunan tensor dengan dimensi tinggi dan lebar yang berbeda (Zhu dkk., 2020:4) sehingga data mampu merepresentasi resolusi hingga tingkat terkecil (detail pixel) berdasarkan tinggi nilai dari indeks daripada nilai $S_i$. Dari hal tersebut, hasil dari fungsi $S_i=backbone(x_{img})$ kemudian disebut dengan feature map yang dinyatakan sebagai $S_i=\{S_3, S_4, S_5\}$ (Zhao dkk., 2024:16968) yang mana arti dari feature map sendiri adalah sekumpulan data feature.
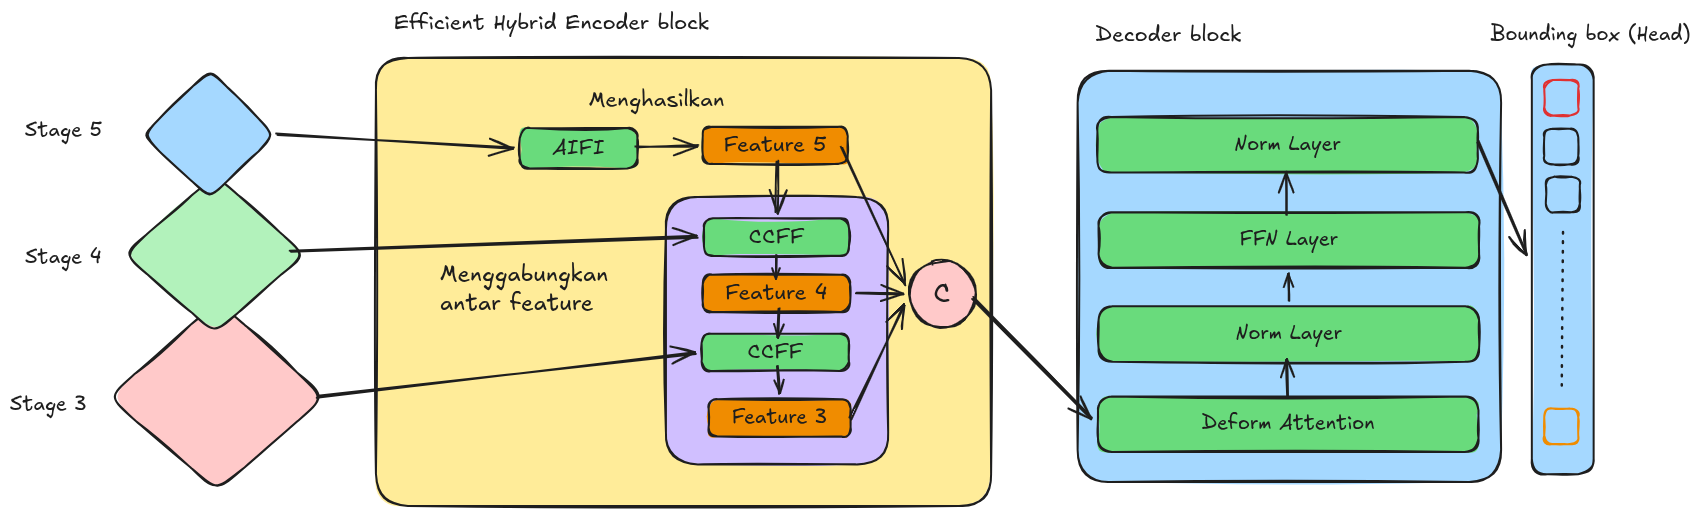
Gambar 1.2 Pemetaan konsep blok dalam AI. Sumber: (Kompetisi Karya Ilmiah oleh Dokumentasi Peneliti, 2026).
Kemudian, agar model AI mampu memahami isi dari gambar tersebut melalui hasil dari feature map $S_i=\{S_3, S_4, S_5\}$ akan diproses pada sebuah blok bernama Efficient Hybrid Encoder yang terdiri dari 2 fungsi program (lihat gambar 1.2) yaitu yang pertama adalah Attention-based Intra-scale Feature Interaction (AIFI) yang terdiri dari 2 lapisan utama.
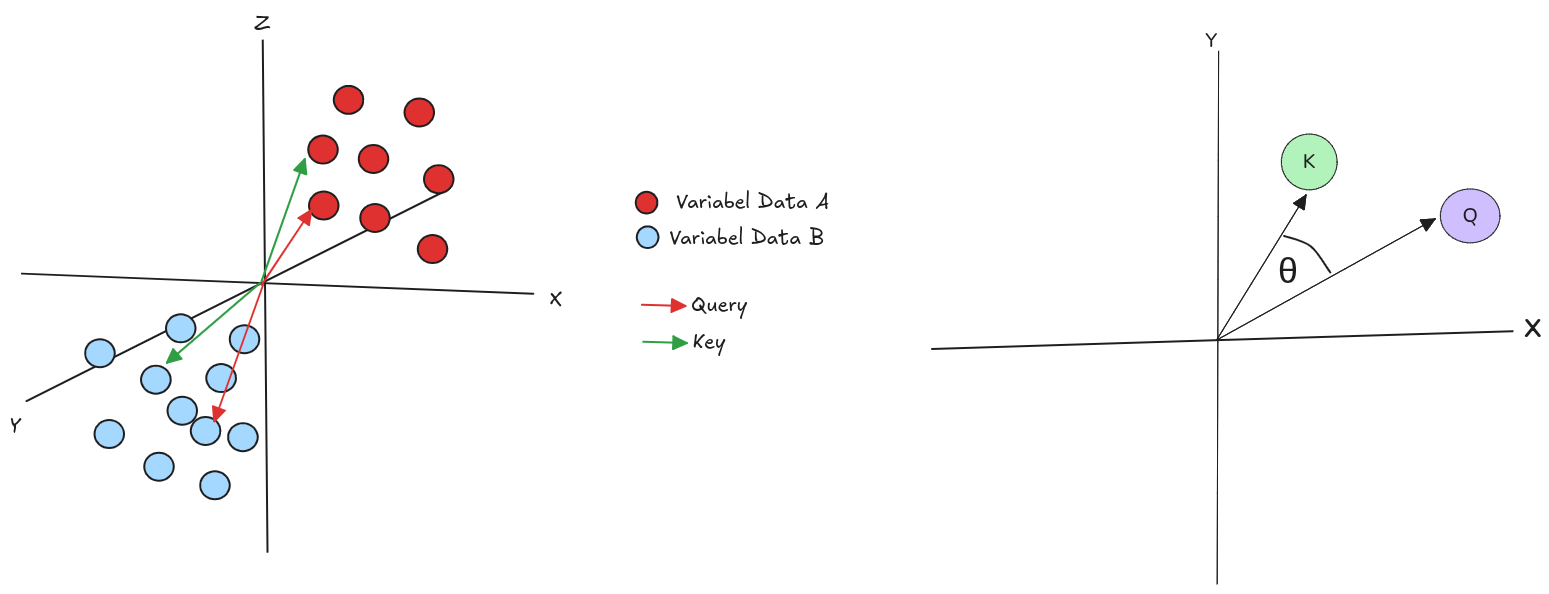
Gambar 1.3 Analisis visualisasi ruang vektor attention. Sumber: (Kompetisi Karya Ilmiah oleh Dokumentasi Peneliti, 2026).
Multi-Head Attention (MHA) merupakan fungsi dari penggabungan (Concat) terhadap sekumpulan Scaled Dot-Product Attention (SDPA) yang dinyatakan sebagai $head_h$, dengan $h>1$ sebagai jumlah head—hal ini membuat model AI dapat mempelajari pola atau informasi yang berbeda pada setiap ruang vektor ($vector space$) yang dihasilkan oleh masing-masing head secara bersamaan. Oleh karena itu, MHA dinyatakan oleh Vaswani dkk., (2017:4) dengan bentuk persamaan: $$MultiHead(Q,K,V)=Concat(head1(Q,K,V), ...... , head_h(Q,K,V))W_O$$ Yang mana head tersebut dinyatakan sebagai (Vaswani dkk., 2017:5) $$ head_i(Q,K,V)=Softmax\left(\frac{QK^T}{\sqrt{d_k}}\right)V $$ Sebagaimana yang telah peneliti tulis persamaan diatas, Query (Q) dan Key (K) direpresentasikan sebagai sekumpulan anak panah dengan warna yang berbeda yang mengarah pada titik sampel. Q merujuk pada anak panah berwarna merah dan K sebagai anak panah berwarna hijau—dimana setiap anak panah Q dan K yang saling berdekatan akan membentuk sebuah sudut $\theta$, semakin dekat sudut dengan anak-anak panah tersebut (panah Q searah dengan panah K) maka skor pada operasi dot product semakin besar karena memiliki kemiripan (similarity). Hasil dari operasi $QK^T$ membentuk vector score yang akan dinormalisasikan oleh $\frac{1}{\sqrt{d_k}}$ yang kemudian seluruh vektor akan diubah dalam bentuk probabilitas oleh fungsi aktivasi softmax dan melakukan operasi dot product dengan nilai V sehingga membentuk representasi akhir dari attention.
2. Feed-Forward Networks (FFN) yang merupakan komponen jaringan saraf pada model AI yang berfungsi untuk memperkaya representasi data tensor terhadap feature melalui operasi non-linear, hal ini dikarena mekanisme attention hampir bersifat linear. Oleh karena itu, lapisan ini dapat dinyatakan sebagai
$$ FFN(x)=max(0, xW_1+b_1)W_2+b_2 $$ Hal ini sejalan dengan penelitian yang dilakukan oleh Vaswani dkk., (2017:5), yang mana fungsi aktivasi dinyatakan dalam $max(0,x)$ yang digunakan model untuk mempelajari pola data dengan menghilangkan feature bernilai negatif (mengubahnya menjadi angka 0) yang berarti data yang tidak sesuai akan dihilangkan.
Sebelum memasuki fungsi berikutnya model terlebih dahulu menghasilkan feature baru yaitu $F5$ melalui $S_5$ yang diratakan (flatten) sehingga dimensi tensor menjadi sebuah urutan (sequence) melalui persamaan $Q=K=V=Flatten(S_5)$ (Zhao dkk., 2024:16969). Persamaan tersebut akan menghasilkan 3 feature dengan nilai Q, K, V untuk digunakan dalam fungsi AIFI dan mengembalikan ukuran dimensi dengan operasi $Reshape(x)$ akibat dari pemerataan. Oleh karena itu, proses tersebut dapat dirumuskan sebagai $$ F5=Reshape(AIFI(Q,K,V)) $$ Selanjutnya, fungsi kedua yang digunakan untuk menggabungkan feature (fusion feature) dari berbagai nilai $S_i$ yang berbeda dan $F_i$ sebelumnya (lihat gambar 1.2) dilakukan dengan fungsi yang disebut dengan CNN-based Cross-scale Feature Fusion (CCFF) (Zhao dkk., 2024:16969) yang kemudian dirumuskan sebagai $$ \begin{align} F4=CCFF({F5,S4}) \\ F3=CCFF({F4,S3}) \end{align} $$ Kemudian hasil dari F3, F4, F5 akan dilakukan penggabungan (Concat) dan menggunakannya sebagai multi-scale feature input pada decoder yaitu blok yang bertanggung jawab untuk membentuk bounding box pada prediksi model—blok tersebut memiliki lapisan bernama Multi-Scale Deformable Attention (MSDeformAttn). Lapisan ini mirip dengan SDPA, namun MSDeformAttn hanya mencari titik pengambilan sampel tertentu (K—Sampling points) pada objek yang dicari ($z_q$). Pada notasinya, nilai F5 pada dasarnya sudah memiliki objek yang terlihat jelas (semantic) pada citra hal ini menjadikan nilai tersebut digunakan sebagai pemilihan kandidat objek yang paling penting dalam proses bernama query selection yang menghasilkan $z_q$ dan juga koordinat referensi yaitu titik pada masing-masing objek yang dinyatakan dalam $p_q \in [0,1]^2, p_q=(x,y)$. Selanjutnya, parameter input dinyatakan dalam $\{x^l\}^L_{l=1}$ yang mana $x^l$ terdiri dari F3, F4, F5 sehingga 3 input akan diproses secara paralel dengan lebih dari 1 skala citra.
Selanjutnya, keluaran dari fungsi MSDeformAttn berupa representasi fitur yang telah menggabungkan informasi dari beberapa tingkat resolusi dan mencari titik sampel tertentu pada objek akan diteruskan ke blok decoder berikutnya secara berulang hingga menghasilkan representasi objek akhir. Representasi tersebut kemudian diproses oleh lapisan FFN Prediction Head untuk melakukan regresi koordinat objek sehingga diperoleh prediksi bounding box yang dinyatakan dalam bentuk $b\in[0,1]^4$ dengan $b=\{b_x,b_y,b_w,b_h\}$ (Zhu dkk., 2021:4).
Sampai jumpa di halaman berikutnya.
Terima kasih telah membaca, dan telah berada di sini.
 Sumber: (Houkago, Bokura wa Uchuu ni Madou, 2025).
Daftar Pustaka
- Zhu, X., Su, W., Lu, L., Li, B., Wang, X., & Dai, J. (2020). Deformable detr: Deformable transformers for end-to-end object detection. arXiv preprint arXiv:2010.04159.
- Zhao, Y., Lv, W., Xu, S., Wei, J., Wang, G., Dang, Q., ... & Chen, J. (2024). Detrs beat yolos on real-time object detection. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition (pp. 16965-16974).
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., ... & Polosukhin, I. (2017). Attention is all you need. Advances in neural information processing systems, 30.
Special thanks to my LKTI friend a.k.a SRA